昨日まで動いていた Python のプログラムが、CSV を読むところで急に止まった。Python が書き出した CSV を Excel で開くと、読めない文字が並んでいる。どちらも、原因はプログラムの書き間違いではないかもしれません。
月末の集計のプログラムが、今朝から止まるんです。何も変えていないのに……。
Python を 3.15 に上げませんでしたか? CSV の読み書きの動きが変わったんです。順に見ていきましょう。
2026年10月9日に公開された Python 3.15 で、文字コードの初期設定が変わりました。同じコードでも、3.14 と 3.15 では読み書きの結果が変わります。この記事では、Windows の Excel と Python 3.14.7・3.15.2 で実際に試した結果と、直し方をまとめます。
変わったこと:open() で encoding を書かないときの文字コードが、Windows の cp932 から UTF-8 に変わりました。
こわいのは書くとき:読むときはエラーで止まります。書くときと行を足すときは、エラーが出ないまま Excel で化けます。
直し方は1つ:encoding を書きます。Excel の CSV を読むなら cp932、Excel で開く CSV を書くなら utf-8-sig です。
# Excel で保存した「CSV」を読む
open("kiroku.csv", newline="", encoding="cp932")

# Excel で開く CSV を書く
open("kiroku.csv", "w", newline="", encoding="utf-8-sig")
いま困っている症状から読むなら、次の表の場所へどうぞ。
| 症状 | 読むところ |
|---|---|
UnicodeDecodeError で止まる | CSV が読めない |
| Python が書いた CSV が Excel で化ける | Excel で化ける |
| 最後に足した行だけ化ける | 足した行だけ化ける |
見出しの列が見つからない(KeyError) | 見えない文字が残る |
| pandas を使っている | pandas の場合 |
自分の Python の版は、次のコマンドで確かめられます。
python --version何が変わったのか
ファイルを開くとき、文字コードを書かないと、Python は初期設定の文字コードを使います。日本語の Windows では、3.14 まで cp932 でした。3.15 からは UTF-8 です。
Python 3.14 まで
encoding なし → cp932
Excel の「CSV」と同じ
Python 3.15 から
encoding なし → UTF-8
Excel の「CSV」と違う
公式の説明は What’s New In Python 3.15 にあります。互換性のために、encoding を必ず書くことも勧めています。
Excel で保存したときの文字コードも確かめました。Excel の「CSV」は cp932、「CSV UTF-8」は BOM(ファイルの先頭に付く印)つきの UTF-8 でした。つまり、Excel でふつうに保存した「CSV」と、3.15 の初期設定が、食い違うようになりました。
CSV が読めない:UnicodeDecodeError
まず、CSV を1行ずつ表示するだけのコードです。encoding を書いていません。
import csv

with open("kiroku.csv", newline="") as f:
    for row in csv.reader(f):
        print(row)
cp932 の kiroku.csv を読むと、3.14 では読めました。同じコードを 3.15 で動かすと、次のエラーで止まります。
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x93 in position 0: invalid start byteエラーの 'utf-8' は「UTF-8 として読もうとしたら、読めなかった」という意味です。cp932 のファイルなので、そう書きます。
with open("kiroku.csv", newline="", encoding="cp932") as f:この1か所を直すと、3.14 でも 3.15 でも読めました。
encoding="shift_jis" と書く例も見かけますが、「①番の棚」を入れた CSV は、shift_jis ではエラーで止まりました。cp932 なら読めました。Windows で作った CSV は cp932 と書くのが安全です。
反対に、エラーに 'cp932' と出るときは、ファイルが UTF-8 かもしれません。encoding="utf-8-sig" を試します。BOM があってもなくても読めました。
Excel で化ける:3.15 が書いた CSV
次は書くほうです。この形が、エラーが出ないぶん気づきにくくなります。
import csv

rows = [
    ["日付", "品目", "金額"],
    ["2026-11-01", "コーヒー豆", 1200],
    ["2026-11-02", "東京都の切手", 840],
    ["2026-11-03", "請求書の封筒", 300],
]

with open("kiroku.csv", "w", newline="") as f:
    csv.writer(f).writerows(rows)
3.14 で動かしてできた CSV を、Excel で開きました。
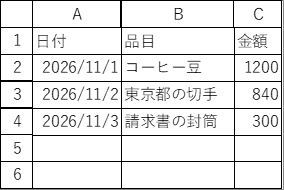
同じコードを 3.15 で動かすと、こうなります。エラーは何も出ません。
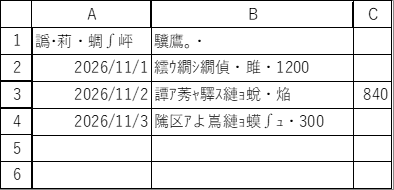
化けた文字がカンマを飲み込むので、列まで崩れます。ただ、いつも崩れるわけではありません。試しに25個の語を「語,100」の形で書いて Excel で開くと、11語は列が崩れ、14語は2列のままでした。
Excel で開く CSV なら、utf-8-sig と書きます。
with open("kiroku.csv", "w", newline="", encoding="utf-8-sig") as f:3.14 でも 3.15 でも同じファイルになり、Excel で正しく開けました。
| CSV を渡す相手 | 書き方 | 気をつけること |
|---|---|---|
| Excel で開く人 | utf-8-sig | いちばん無難です |
| 文字コードの決まりがある仕組み | 相手の決まりに合わせる | cp932 と決まっていれば cp932 |
cp932 では絵文字を書けません。「とても良い😀」を書くと UnicodeEncodeError で止まりました。utf-8-sig なら書けました。
足した行だけ化ける:いちばん気づきにくい形
記録のファイルは開けるんです。でも、今朝足した行だけ文字がおかしくて。
それがいちばん気づきにくい形です。エラーが出ないまま、1つのファイルに2つの文字コードが混ざります。
毎日1行ずつ足していく記録の CSV は、とくに注意が要ります。3.14 で作った kiroku.csv に、3.15 で次のコードを動かしました。
import csv

with open("kiroku.csv", "a", newline="") as f:
    csv.writer(f).writerow(["2026-11-04", "東京都の切手", 840])
エラーは出ません。Excel で開くと、足した行だけが化けています。
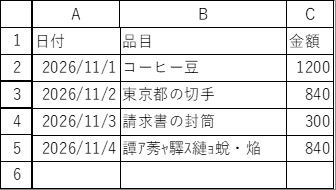
このファイルは、encoding="cp932" でも encoding="utf-8" でも、最後まで読めませんでした。3.14 の指定なしでも 3.15 の指定なしでも止まります。何日も気づかないと、化けた行が増えていきます。
「順に試す」でも安心できない
文字コードが分からないときに、utf-8-sig がだめなら cp932、と順に試す書き方があります。ふつうのファイルには便利ですが、混ざったファイルには向きません。
cp932 の見出しのあとに、UTF-8 の行を1行足して試しました。語を25個入れ替えると、11語は止まり、14語はエラーなしで読めてしまいました。「読めた」と表示されても、足した行は化けたままです。読めたあとは、中身を見てください。
混ざったファイルを直す
1行ずつ、まず UTF-8 で読み、だめなら cp932 で読み直して、utf-8-sig で別のファイルに保存します。
from pathlib import Path

src = Path("kiroku.csv")            # 混ざってしまったファイル
dst = Path("kiroku_naoshita.csv")   # 直したあとのファイル(元は残す)

lines = []
for raw in src.read_bytes().splitlines():
    try:
        lines.append(raw.decode("utf-8"))
    except UnicodeDecodeError:
        lines.append(raw.decode("cp932"))

dst.write_text("\r\n".join(lines) + "\r\n", encoding="utf-8-sig", newline="")
print(len(lines), "行を書きました")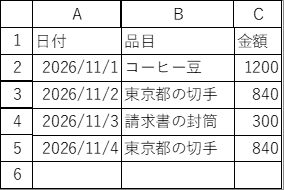
行ごとの判定は、いつも当たるとは限りません。日本語の語を15個試したときは、cp932 の語を UTF-8 と取り違えることはありませんでしたが、すべての文字を確かめたわけではありません。元のファイルは残し、直したあとの中身を目で見てください。1行の中で文字コードが混ざったファイルは、この方法では直りません。
見えない文字が残る:KeyError
Excel の「CSV UTF-8」は、先頭に BOM が付きます。これを encoding="utf-8" で読むと、エラーは出ませんが、1列目の見出しの前に見えない文字が残ります。
見出し ['日付', '品目']
KeyError: '日付'画面では「日付」に見えるのに、row["日付"] が見つからないのは、この形です。3.15 では、encoding を書かずに読んでも同じことが起きます。encoding="utf-8-sig" で読むと、見えない文字は残りません。
pandas の場合
read_csv と to_csv の動きは、Python 3.14.7(pandas 3.0.5)と Python 3.15.2(pandas 3.1.0)で同じでした。データ分析の基本はpandas の入門記事にまとめています。
| やること | 結果 |
|---|---|
read_csv で UTF-8 を読む | 指定なしで読める(BOM つきも) |
read_csv で Excel の「CSV」を読む | 指定なしは止まる。encoding="cp932" で読める |
to_csv で書く | 指定なしは BOM なしの UTF-8 |
pandas だけのコードは、3.15 にしても変わりません。ただ、to_csv は 3.15 より前から BOM なしの UTF-8 で書きます。Excel で開くなら、df.to_csv("kiroku.csv", index=False, encoding="utf-8-sig") と書いてください。
例外は、open() で開いたファイルを pandas に渡す形です。この形だけは 3.14 が cp932、3.15 が UTF-8 と変わりました。
3.15 に上げる前にしておくこと
encoding を書いていない所を探す
3.14 のまま、次のように動かすと、encoding がない所を教えてくれます。ふつうに動かしても、この警告は出ません。
python -X warn_default_encoding kaku.pykaku.py:10: EncodingWarning: 'encoding' argument not specified
with open("kiroku.csv", "w", newline="") as f:出た場所に、そのファイルの文字コードを書いていきます。動かした所しか警告は出ないので、ふだん通らない処理も動かしてみてください。
急ぎのときは、元の動きに戻す
今日の仕事を止められないときは、3.15 のまま前の動きに戻せます。PowerShell なら次のとおりです。
$env:PYTHONUTF8 = "0"
python yomu.py
1回だけなら python -X utf8=0 yomu.py でも同じでした。どちらも 3.15 で cp932 の CSV を読めました。ただ、これは一時しのぎです。別のパソコンで動かすとまた止まるので、あとで encoding を書いてください。
早見表:どの読み方で読めたか
| ファイル | 3.14 指定なし | 3.15 指定なし | cp932 | utf-8 | utf-8-sig |
|---|---|---|---|---|---|
| Excel の「CSV」(cp932) | 読める | 止まる | 読める | 止まる | 止まる |
| UTF-8(BOM なし) | 止まる | 読める | 止まる | 読める | 読める |
| Excel の「CSV UTF-8」(BOM つき) | 止まる | 文字が残る | 止まる | 文字が残る | 読める |
「文字が残る」は、1列目の見出しの前に見えない文字が残ることです。この表は4行の試しのファイルの結果です。中身によっては、「止まる」所がエラーなしで化けて読めることがあります。
よくある質問
3.15 に上げないほうがいいですか
急いで上げる必要がないなら、encoding を書いてから上げるのが安全です。3.14 も、3.15 と同じ10月25日に新しい版(3.14.10)が出ていました。これから始める人は、最初から encoding を書く形で覚えれば、3.15 で始められます。始め方はインストールとエディタの準備にまとめています。
errors=”ignore” を付ければ止まりませんか
止まりませんが、勧めません。混ざったファイルを encoding="utf-8", errors="ignore" で読むと、エラーは消えた代わりに、cp932 の行の日本語が失われました。止まらないだけで、データは直っていません。
家計簿の CSV も直す必要がありますか
encoding が書いてあれば、3.15 でも変わりません。家計簿を自動集計する記事のように、読むときに文字コードを書いているコードは、この変更の影響を受けません。
まとめ
- Python 3.15 で、
encodingを書かないときの文字コードが UTF-8 に変わりました。 - 読むときはエラーで止まります。書くときと足すときは、エラーなしで Excel で化けます。
- Excel の「CSV」を読むなら
cp932、Excel で開く CSV を書くならutf-8-sigです。 - 行を足す CSV は、Python を上げる前に
encodingを書いてください。 - 混ざったファイルは1行ずつ読み直して戻せることがあります。必ず写しで試してください。
行を足すプログラムには、今日のうちに encoding を書いておきます。
はい。書いておけば、3.14 でも 3.15 でも同じ動きになります。混ざったファイルを直すときは、写しで試してくださいね。
確かめていないこと
- Mac・Linux では試していません。この記事の「3.14 まで cp932」は日本語の Windows の話です。
- Excel は「開く」と「保存」だけを試しました。データの取り込みの機能は試していません。
- Excel の版は1つだけです。古い版の Excel では試していません。
- 列が崩れる語の数は、選んだ25語の結果です。すべての語の割合ではありません。
- 文字コードを自動で見分けるライブラリは比べていません。
検証した環境:Windows 11 / Python 3.14.7(pandas 3.0.5)/ Python 3.15.2(pandas 3.1.0)/ Excel 16.0。試し用の CSV は Python で作りました。記事のコードは 3.14.7 と 3.15.2 の両方で動かしています(2026年11月4日)。
コメント