パソコンの決まった作業を自動化したい。そう思って調べると、だいたい2つの道が出てきます。Pythonでプログラムを書くか、RPAという道具を使うか。
どちらがいいのか、正直わたしも分かっていませんでした。なので、まったく同じ仕事を両方で作ってみました。
先に言っておきます。この記事では、どちらが優れているかは書きません。作ってみて分かったのは、優劣ではなく性格がまるで違うということだったからです。代わりに、実際に違ったところをそのまま並べます。読み終わったとき、ご自分で選べるようになっていれば成功です。
その前に:RPAは、もうあなたのパソコンに入っています
RPAというと会社のシステムの話に聞こえますが、Windows 11には最初から「Power Automate」というRPAソフトが入っています。個人で使うぶんには無料です。
わたしはこの記事を書くまで、入っていることを知りませんでした。Pythonの記事を書いていて、これです。ですので、ご存じなくても何もおかしくありません。
やらせたのは、まったく同じ1つの仕事
条件をそろえないと比べられないので、次のように決めました。
| 項目 | 決めたこと |
|---|---|
| やること | 決まったページを見に行き、前回と中身が変わっていたら知らせる |
| 見に行くページ | 自分のサイトのカテゴリーページ(他所様のサイトに何度もアクセスしないため) |
| 取るもの | ページの一番上にある記事タイトル、1か所だけ |
| 知らせ方 | まずは画面に出すところまで |
| 間隔 | 1時間ごと |
Python側の作り方は、この記事では要点だけにします。手順をひととおり知りたい方は、下の記事にまとめてあります。メール通知や1時間ごとの自動実行まで通しで書いています。
Python版の詳しい手順はこちら
Pythonで作ると、こうなりました
準備は、コマンドを1行打つだけです。
pip install requests beautifulsoup4手元で計ったら19秒でした。あとはファイルを1つ作って、次のように書きます。
import requests
from bs4 import BeautifulSoup
from pathlib import Path

URL = "https://(見に行きたいページ)/"
SELECTOR = "h2.entry-card-title"

SAVE_FILE = Path("last_value.txt")
HEADERS = {"User-Agent": "Mozilla/5.0 (check-script; personal use)"}

response = requests.get(URL, headers=HEADERS, timeout=20)
response.raise_for_status()

soup = BeautifulSoup(response.text, "html.parser")
element = soup.select_one(SELECTOR)
if element is None:
    print("見つかりませんでした。ページの作りが変わったかもしれません")
    raise SystemExit(1)

current = element.get_text(strip=True)

if not SAVE_FILE.exists():
    print("初回の記録です:", current)
elif SAVE_FILE.read_text(encoding="utf-8") != current:
    print("変化がありました")
    print("  前回:", SAVE_FILE.read_text(encoding="utf-8"))
    print("  今回:", current)
else:
    print("変化はありませんでした:", current)

SAVE_FILE.write_text(current, encoding="utf-8")コメントと空行を除くと24行です。書き換えるのは上の2か所、見に行くページと、取る場所の指定だけ。
一発で動きました。途中で詰まったところは、ひとつもありません。
RPAで作ると、こうなりました(4回つまずきます)
ここからが本番です。実際に詰まった順番のまま書きます。きれいな手順書に整えてしまうと、この記事を書いた意味がなくなるので。
つまずき1:そもそもアプリが開けない
ネットの解説は、どれも「Power Automate Desktop」と書いています。そこでスタートメニューにそう入力したら、アプリではなくブラウザが開きました。
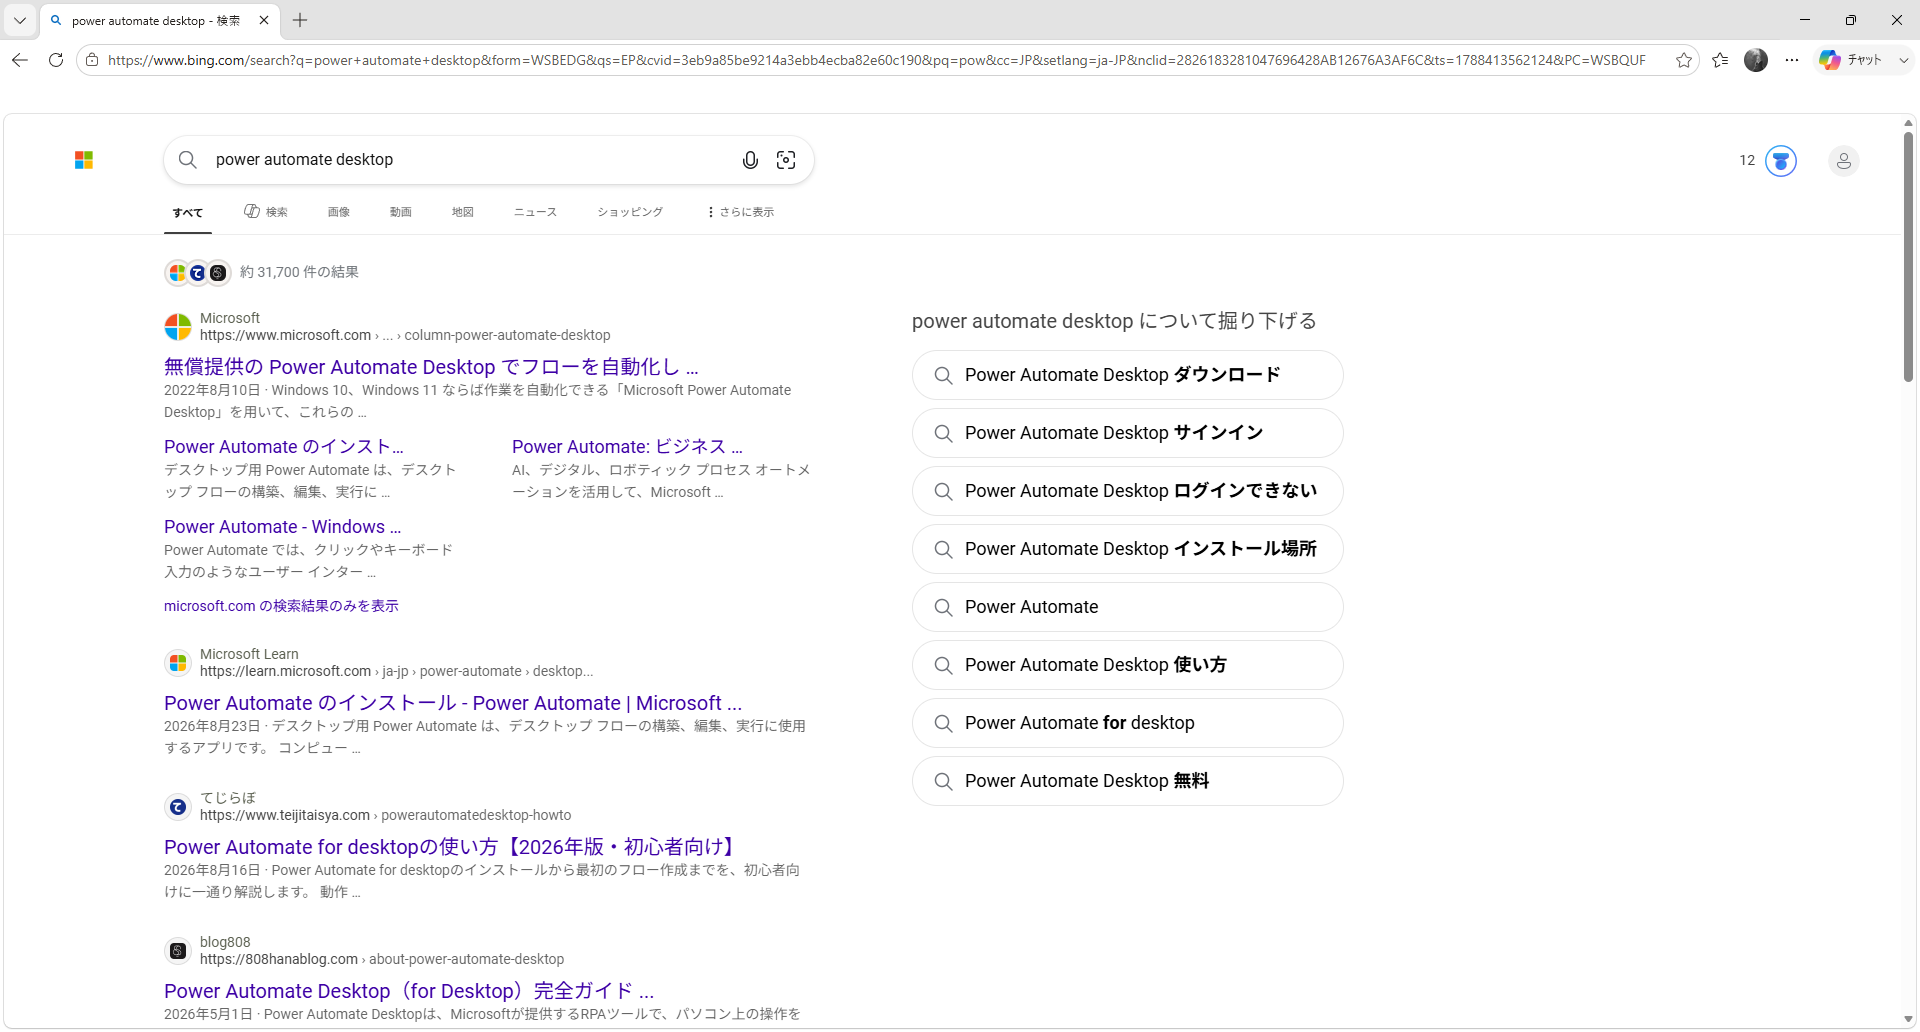
原因は単純で、アプリの名前は「Power Automate」で、「Desktop」が付かないからです。名前がぴったり一致しないので、Web検索の結果のほうが目立つ位置に出ます。
「power automate」だけで検索すれば、ちゃんと出てきます。
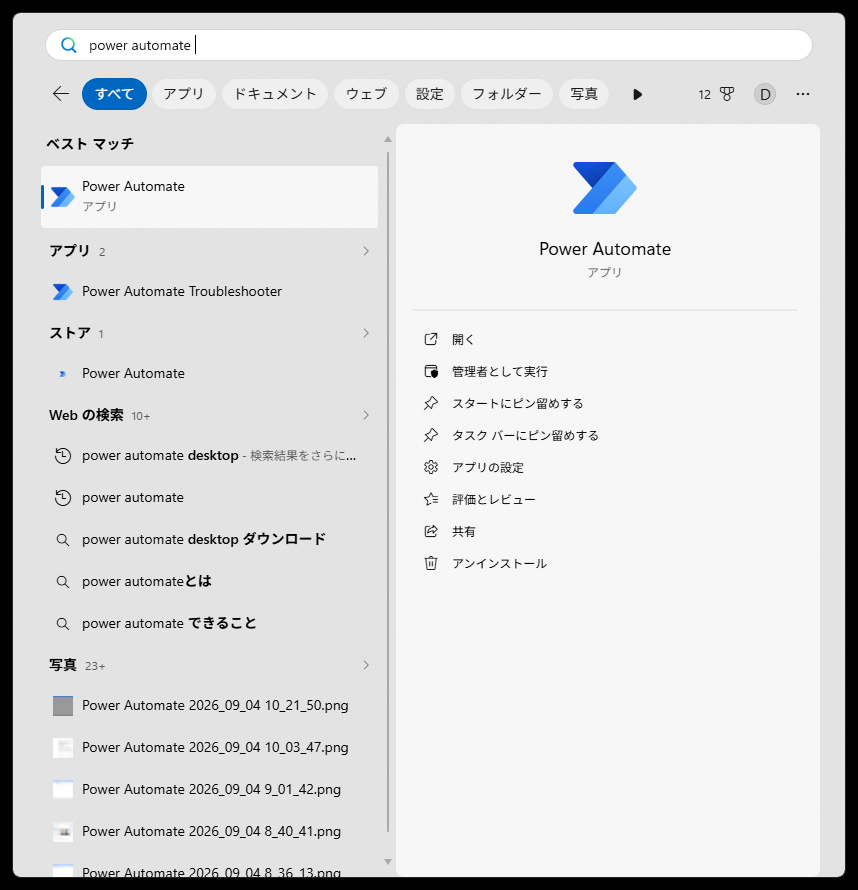
スタートメニューの「すべてのアプリ」を上から探す方も多いと思います。ところが、わたしのパソコンでそこに並んでいたのは 「Power Automate Troubleshooter」だけでした。本体は一覧に出ていません。
Troubleshooter は名前のとおり不具合を診断するための別のアプリで、開いても作業画面にはなりません。一覧から探すと、こちらを開いてしまいます。
結局、検索ボックスに「power automate」と打って、ベストマッチに出てきたものをクリックするのが、いちばん確実です。
「インストール場所はどこ?」と探しても、たぶん見つかりません。実体は隠しフォルダの中にあり、表示する設定にしても、開こうとすると拒否されます。ネットの解説によく出てくる C:\Program Files (x86)\Power Automate Desktop\ は、わたしのパソコンには存在しませんでした。
つまずき2:開いた瞬間、英語で更新が始まる
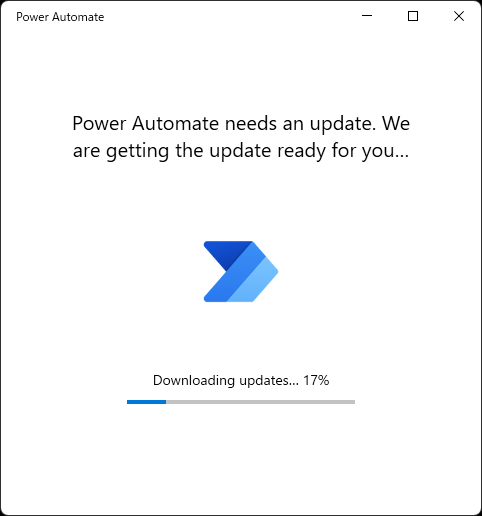
待ち時間は約2分。前後でバージョンを見たら 1.0 から 11.x に変わっていました。ちょっとした更新ではありません。
つまり、最初から入っているのは入り口だけで、本体は初めて開いたときに降ってきます。「インストール不要ですぐ使える」という説明は、実態とは少しずれています。
つまずき3:サインインを求められる
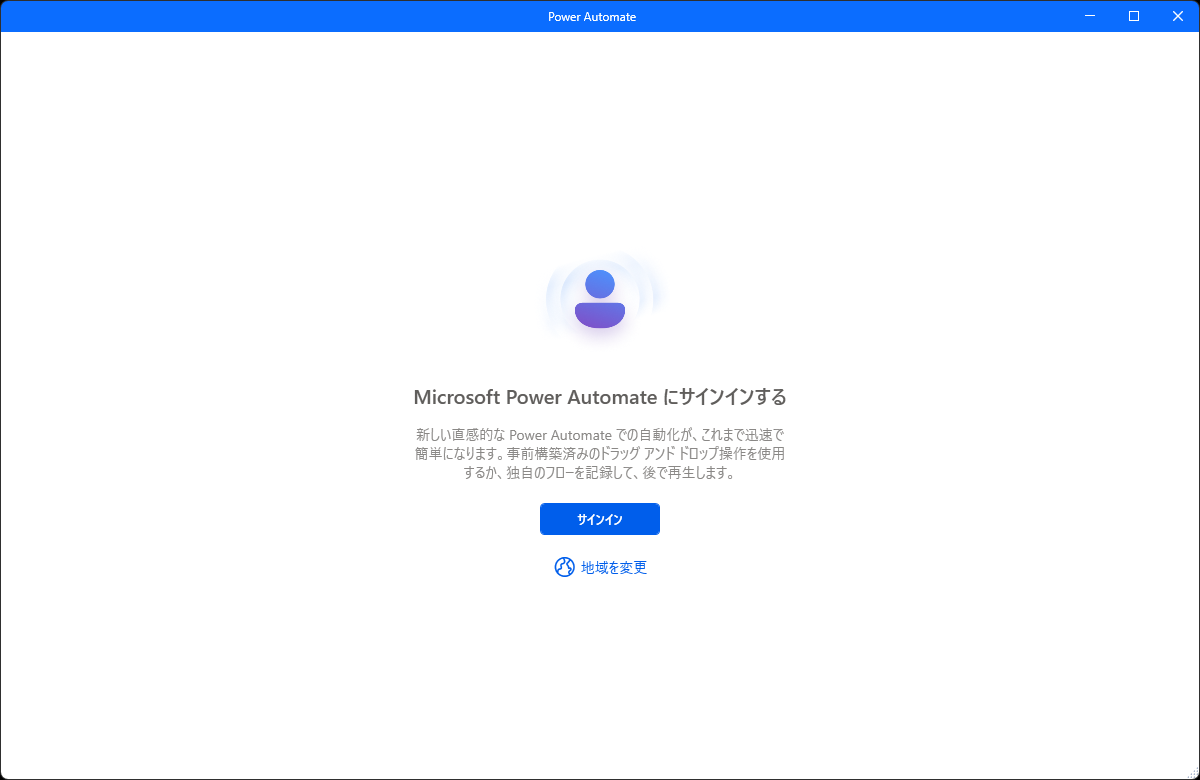
Microsoftアカウントが必要です。このあと「必須データの収集」「国や地域の選択」「かんたんツアーの案内」と続き、作業画面にたどり着くまでに5枚のダイアログを閉じました。
アプリを開いてから使える状態になるまで、約7分でした。
19秒 対 7分。数字だけ見るとPythonが速いようですが、前提が違います。Python側は「Pythonがすでに入っている」ことが前提で、その準備だけで記事1本ぶんの話になります。RPA側は本当に何も入れなくていい。どちらにも前提があります。
つまずき4:最初の実行が、失敗しました
「ブラウザを開いてページを見に行く」という命令を1つ置いて実行したら、いきなりこれです。
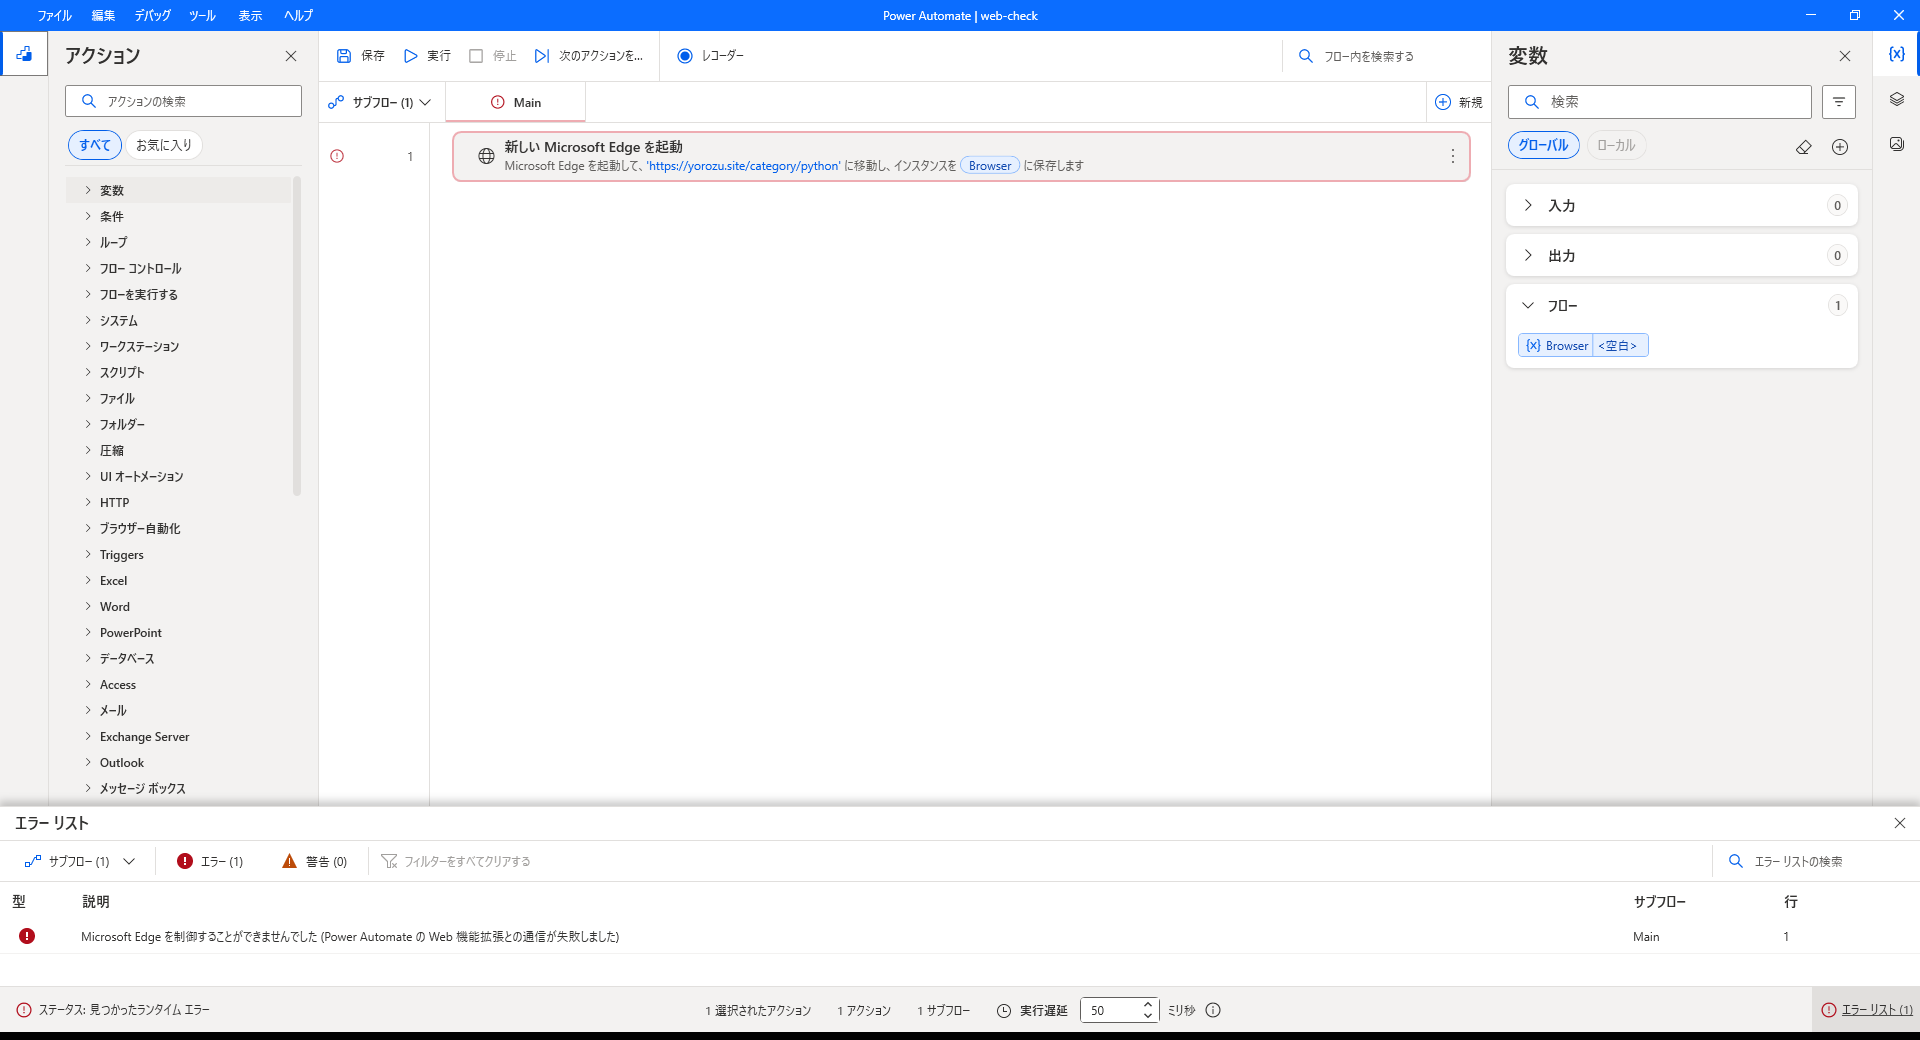
ブラウザの拡張機能が要るようです。調べに行ったら、こう書いてありました。
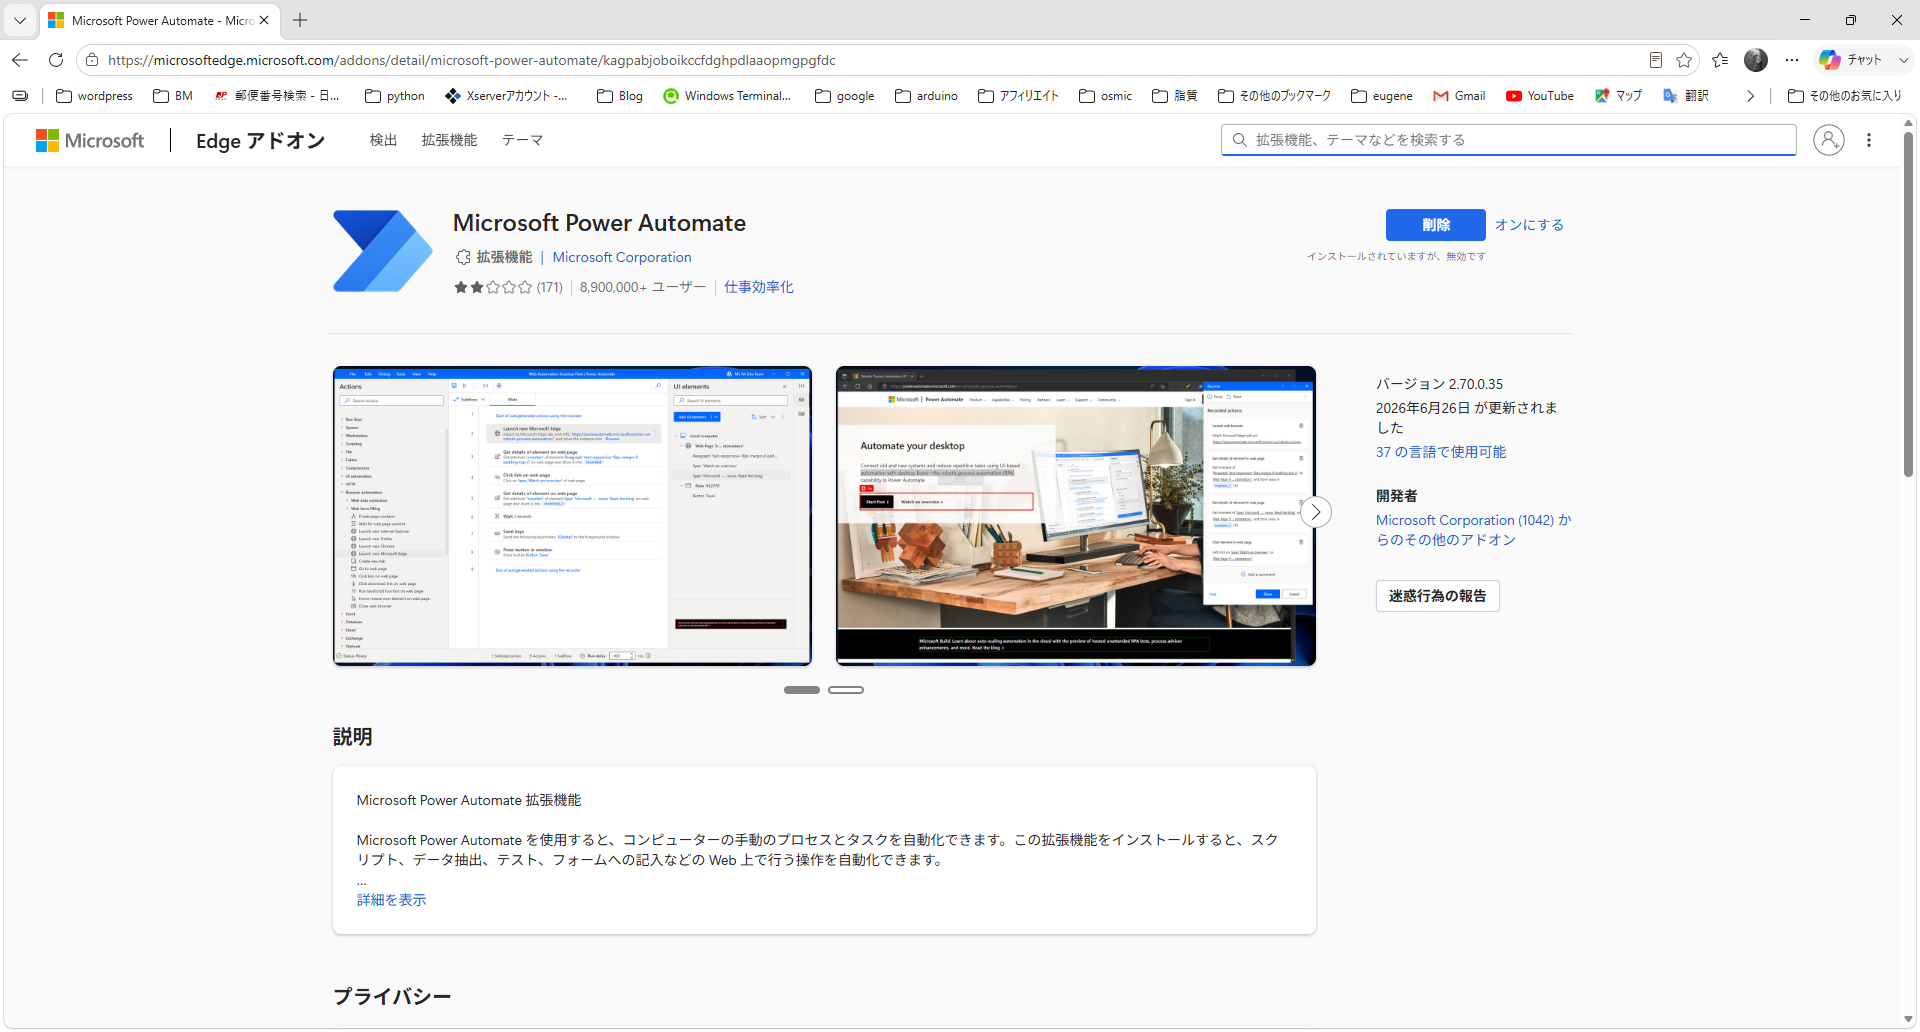
拡張機能は最初から入っていて、しかも無効の状態で置かれています。自分で「オンにする」を押さないと、いつまでも動きません。これは知らないと、まず分かりません。
この記事を書いたあと、Power Automateを一度も開いたことがない別のパソコンでも試しました。そちらでも同じところで止まりました。原因も同じで、拡張機能が無効のまま入っていました。
ただし試したのは2台だけです。公開時の見出しは「最初の実行は、必ず失敗する」でしたが、1台で確かめた時点で「必ず」と書いていました。2台とも同じ形でしたが、すべてのパソコンでそうなると確かめたわけではありません。見出しを直しました。
そのかわり、ここは圧倒的に分かりやすい
悪いところばかり書きましたが、RPAがはっきり優れている場面もありました。「ページのどこを取るか」を決めるところです。
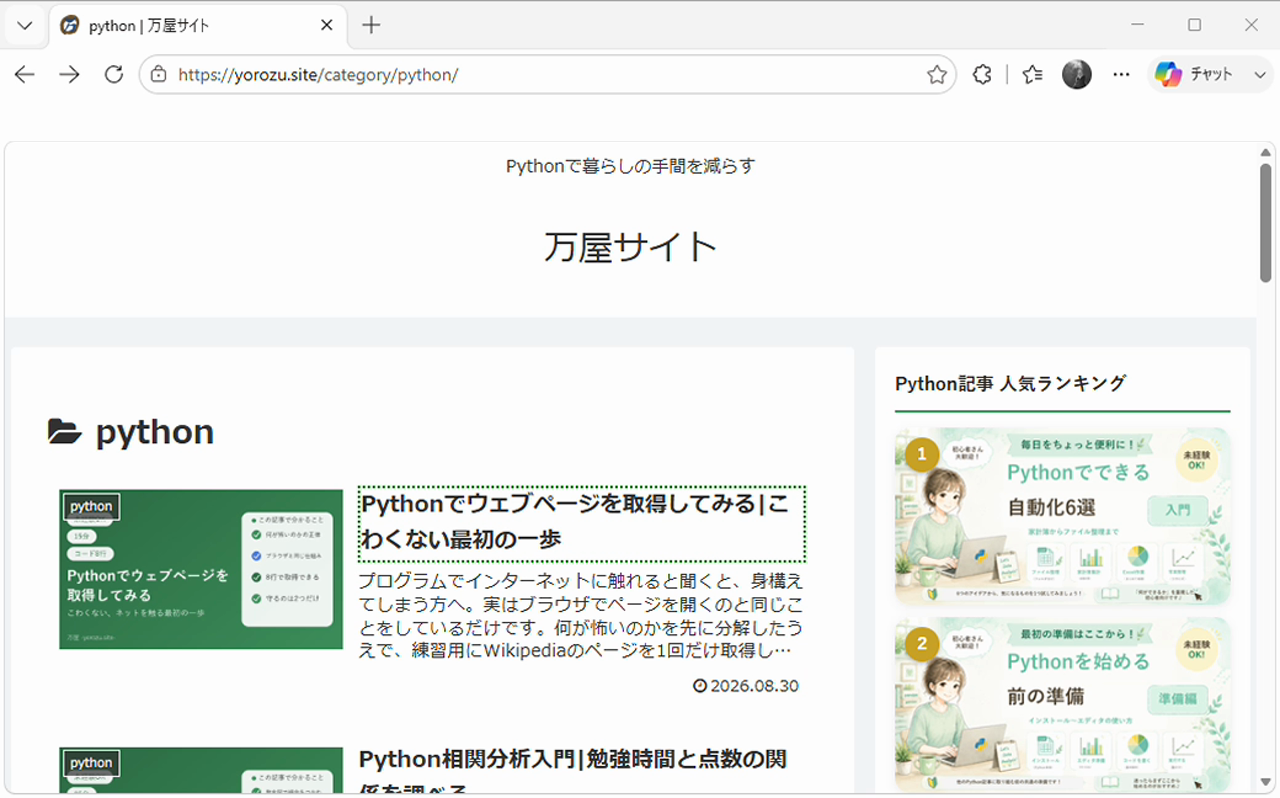
Pythonでは h2.entry-card-title のような指定を自分で書く必要があります。そのためには、先にページの中身を調べないといけません。
正直に言うと、わたしはこれを最初に間違えました。自分のサイトなのに、思っていた指定では1つも取れなかったのです。RPAなら、指さすだけで済みます。ここは本当に楽です。
結果は、まったく同じでした
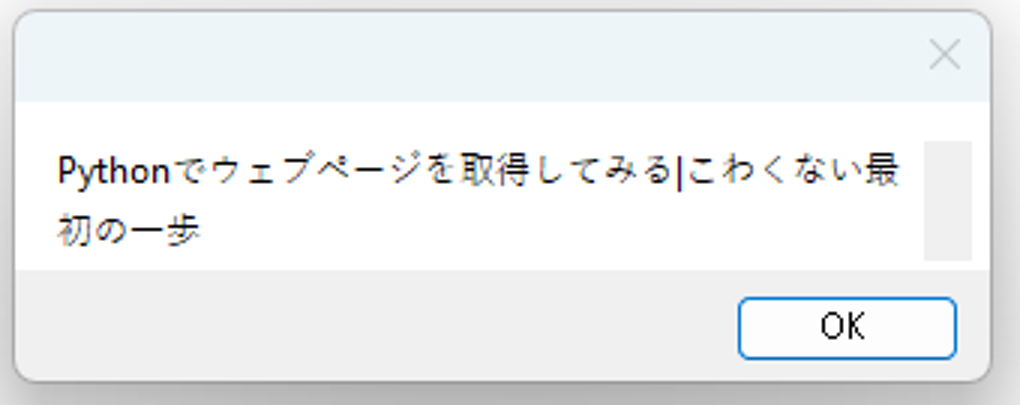
Python側の出力と並べてみます。
| 出てきたもの | |
|---|---|
| Python | Pythonでウェブページを取得してみる|こわくない最初の一歩 |
| RPA | Pythonでウェブページを取得してみる|こわくない最初の一歩 |
1文字も違いません。
ここで「どちらが優れているか」という問いは、いったん崩れます。やりたいことができるかどうかで言えば、両方できます。片方は35行、もう片方は命令3つ。かかった時間も、ならしてみれば大差ありません。
ただし、これは「このページでは」という話です。あとで、片方だけ取れないページも出てきます。
では何が違うのか。ここから先が本題です。
壊れ方が、正反対でした
自動化したものは、いつか必ず動かなくなります。見に行く先のページのほうが変わるからです。そのとき、どちらがどう壊れるのか。調べてみたら、はっきり分かれました。
それぞれが「どこを取るか」をどう覚えているか
RPA側が内部で持っていた指定が、こちらです。
html > body > div:eq(0) > div:eq(1) > div > main > div:eq(0) > a:eq(0) > article > div > h2Python側は、こうでした。
h2.entry-card-title長さがまるで違います。それ以上に大事なのは、見ているものが違うことです。
- RPAは「順番」を見ています。上から何番目のかたまりの、その中の何番目の……と、たどっています
- Pythonは「名前」を見ています。順番は関係なく、その名前が付いた場所を探します
実際に、ページを4通りに変えて試しました
実際のページを取ってきて、手元で少しずつ書き換え、両方の指定を当ててみました。
| ページに起きたこと | RPA | Python |
|---|---|---|
| 何も変えない | ○ 取れる | ○ 取れる |
| お知らせバーが1つ増えた 広告やCookieの同意バーなども同じです | × 取れない | ○ 取れる |
| デザイン更新で名前だけ変わった 並び順はそのまま | ○ 取れる | × 取れない |
| 見出しの種類そのものが変わった | × 取れない | × 取れない |
両方壊れます。ただし、壊れる条件が正反対でした。
RPAは、ページに何か1つ足されるだけで狂います。お知らせバーが出た、広告が入った。それだけで「上から2番目」の中身が変わってしまうからです。これは、わりとよく起きます。
Pythonは、順番が変わっても平気です。そのかわり、サイトのデザインが大きく変わって名前が付け替えられると、探せなくなります。
この4通りは、実際のページを書き換えて試したものではなく、取ってきたページを手元でいじって試したものです。またRPA側の指定は、自動で作られたものをそのまま使っています。
じつは、RPA側も書き換えられます
「自動で作られたものをそのまま使っている」と書きました。では手で直せないのか。気になったので試したところ、直せました。
やり方は、命令を1回クリックして Ctrl+C。そのままメモ帳に貼ると、設定が文字として出てきます。そこを書き換えて、コピーしてPADに貼り戻すと、反映されます。
実際に、あの長い指定を .price という名前だけの指定に書き換えて貼り戻し、ちゃんと動くところまで確認しました。つまりRPAでも、Pythonと同じ「名前で探す」やり方にできます。
画面のどこにも「指定を編集する」というボタンはありません。命令をコピーして、メモ帳で書き換えて、貼り戻す。この手順を知らないと、まずたどり着けません。
ですので「直せるから大丈夫」とは言いにくいところです。はじめての方は、自動で作られたまま使うことになります。上の表は、その姿で比べたものです。
もうひとつ、逆向きの大きな差がありました
ここまでは「同じ結果が出る」を前提に書いてきました。でも、それが崩れる場合があります。
いまのWebページには、最初に届くHTMLには値が書かれていなくて、ブラウザが後からJavaScriptで表示しているタイプのものがたくさんあります。通販サイトの価格などは、たいていこれです。
Pythonのこの作り方は、届いたHTMLをそのまま読みます。ブラウザは使いません。だから後から表示される値は、そこに存在しません。
RPAは実際にブラウザを開いて、画面から拾います。だとしたら、取れるはずです。試しました。
テスト用のページを1枚作って、両方に読ませました
商品名と価格を、JavaScriptで後から表示するだけのページです。ブラウザで開くと、こう見えます。
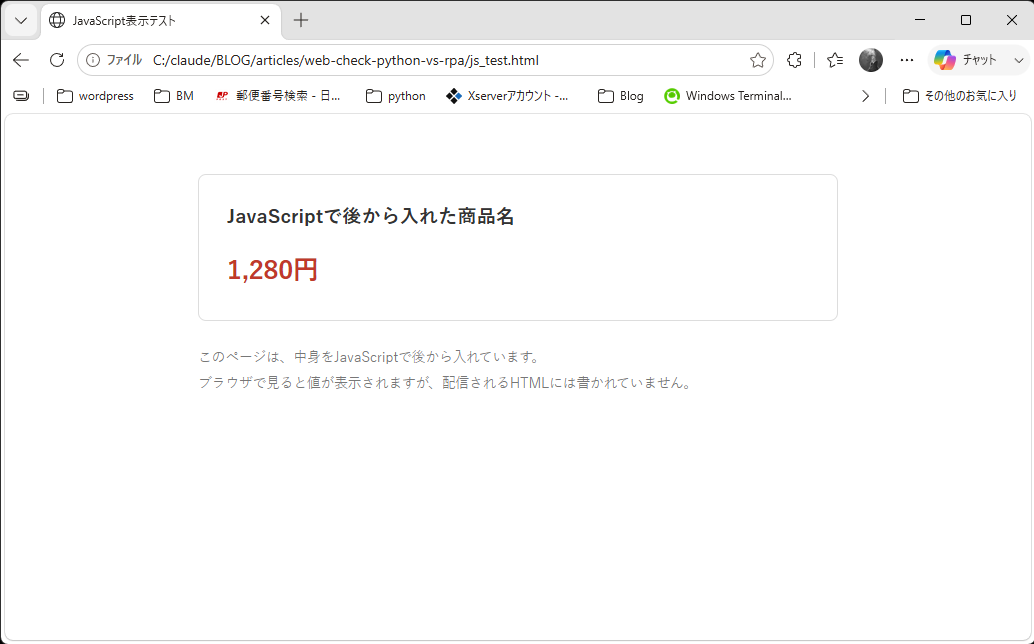
| 取ろうとしたもの | Python | RPA |
|---|---|---|
| 商品名 | 「読み込み中…」 エラーにならず、間違った値が取れる | - |
| 価格 | 見つからない 要素そのものが存在しない | 1,280円 取得できた |
ここは、RPAだけが取れました。Pythonでは要素すら存在しなかったものです。
そしてPython側の商品名のほうが、実は厄介です。「読み込み中…」という、表示前の文字が取れてしまいました。エラーは出ません。気づかないまま、ずっと間違った値を記録し続けることになります。
「値段が下がったら教えてほしい」という、いちばんやりたい使い方が、まさにこの形です。そういうページを見張りたいなら、Pythonのこの作り方では届きません。
Pythonでも、ブラウザを動かすやり方(SeleniumやPlaywright)を使えば取れます。ただし、そこから先はもう手軽ではありません。
このテストは、自分で作ったページをパソコンの中に置いて行いました。よそ様のサイトに何度もアクセスしないためです。
そして、いちばん差がついたところ
ここまでは引き分けに近い話でした。決定的に分かれたのは、「毎時間、勝手に動かす」ところです。
そもそもこれをやりたくて自動化するわけですから、いちばん大事な部分です。
Python側
起動用のファイルを1つ作って、Windowsのタスクスケジューラに登録するだけでした。実際に登録して動かし、結果が記録されるところまで確認しました。パソコンの前にいなくても動きます。
RPA側:まず、定期実行の機能がありません
探しましたが、時間になったら動かす仕組みが見当たりません。命令の一覧にも、作ったものを右クリックしたメニューにもありませんでした。
唯一あるのが「デスクトップ ショートカットを作成」です。ショートカットを作れば、タスクスケジューラから呼べます。実際に登録してみました。
RPA側:呼ぶたびに、これが出ます
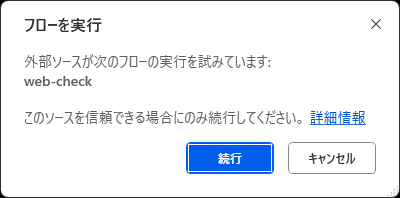
人が「続行」を押さないと、動きません。
これに気づくまで、しばらく「動いたり動かなかったりする」と勘違いしていました。実際は押したものが動き、押していないものが止まっていただけです。
設定で消せないかと思って全部見ましたが、それらしい項目はありませんでした。
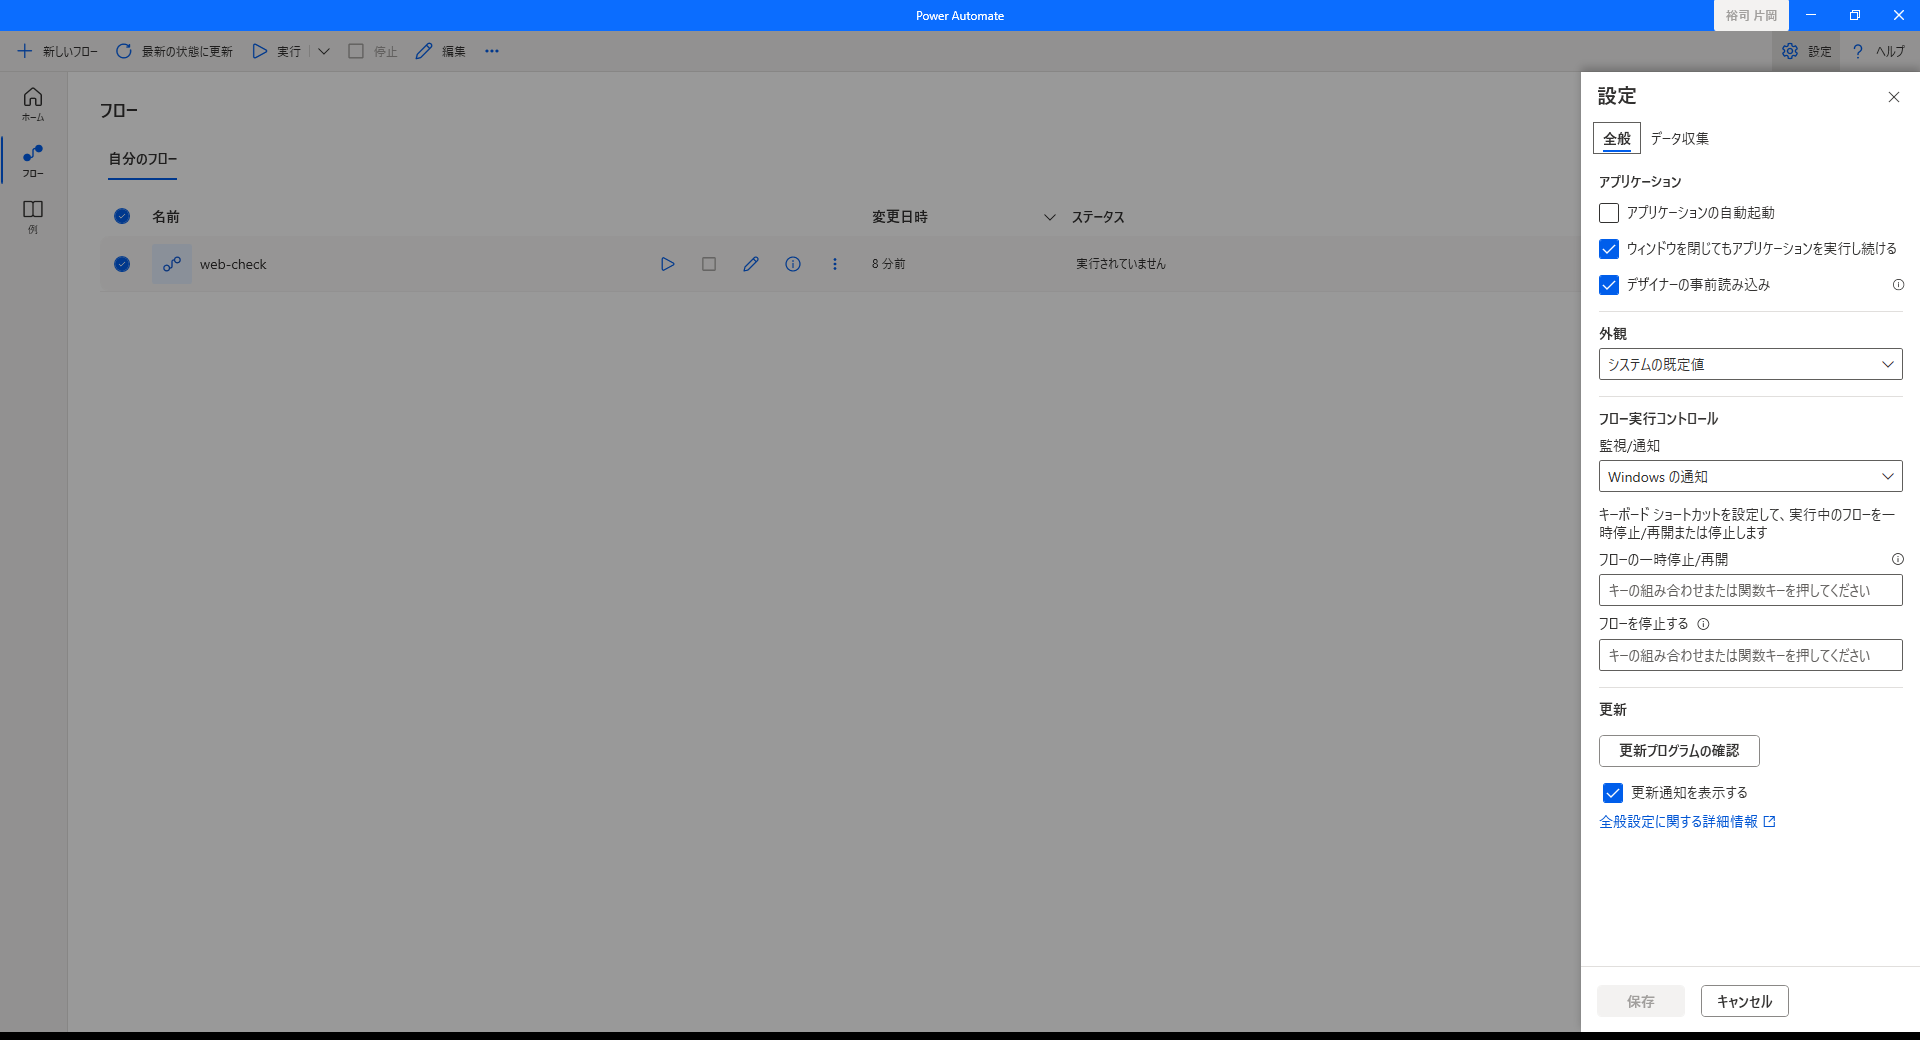
公式のドキュメントを読むと、Windowsのレジストリを編集すれば消せると書いてありました。ただ、これは安全のための確認です。暮らしの手間を減らすために、パソコンの安全設定を触るのは、割に合わないと思います。
無料のまま、普通の使い方をする範囲では、RPAに留守番はさせられません。「毎時間、いない間も見張っていてほしい」という目的に対して、片方は成立し、片方は成立しませんでした。
これは好みの問題ではありません。やりたいことに合うかどうかの問題です。
で、どちらを選べばいいのか
決めません。ここまで書いておいて逃げるようですが、本当に人によるからです。
代わりに、線を1本だけ引きます。選ぶときは、ここを見てください。
「どちらの壊れ方なら、自分で直せそうか」
RPAは、ページに何か足されると止まります。もう一度画面から指し直せば直りますが、なぜ止まったのかは分かりにくいです。Pythonは、止まった理由が文字で出ます。そのかわり、その文字を読む気がないと直せません。
それと、はっきりしている分かれ道が2つあります。
留守中も動いていてほしいなら、いまのところPythonです。逆に、自分がパソコンの前にいるときに「押したら勝手にやってくれる」でよければ、RPAのほうが速く作れます。画面を指すだけですから。
そして見張りたいページが、JavaScriptで表示されるタイプなら、RPAです。通販サイトの価格などは、たいていこれです。Pythonのこの作り方では、そもそも届きません。
迷ったら、両方1回ずつ作ってみるのがいちばん早いと思います。この記事のとおりにやれば、どちらも1時間はかかりません。そして、たぶん作っている最中に「自分はこっちが好きだ」と分かります。
まとめ
| Python | RPA(Power Automate) | |
|---|---|---|
| 準備 | コマンド1行・19秒 Pythonの導入は別途必要 | 約7分+ダイアログ5枚 何も入れなくていい |
| アカウント | 要らない | Microsoftアカウントが要る |
| 作るまでに詰まった回数 | 0回 | 4回 |
| 取る場所の決め方 | 自分で書く(先に調べる) | 画面で指すだけ |
| 出てきた結果 | 同じ | 同じ |
| JavaScriptで表示されるページ 通販サイトの価格など | 取れない | 取れる |
| お知らせバーが増えたら | 平気 | 止まる |
| デザイン更新で名前が変わったら | 止まる | 平気 |
| 止まった理由 | 文字で出る | 分かりにくい |
| 留守中の自動実行 | できる | 毎回「続行」が要る |
同じ仕事をさせて、同じ結果が出て、それでもここまで性格が違いました。優劣ではなく、向き不向きなのだと思います。
次に読むなら
Pythonでウェブページの更新・価格変動を自動チェックする方法
この記事で使ったPython版を、メール通知や1時間ごとの自動実行まで通しで作る手順です。実際に動かすところまで書いています。
この記事を確かめた環境
Windows 11 Pro(26200) / Python 3.14.7 / Power Automate 11.2608.115.0
画面はすべて2026年9月3日から4日に撮ったものです。うまくいかなかったことも含めて、実際に手を動かして確かめた範囲だけを書いています。なお、確認のダイアログをレジストリで消す方法は、公式に記載があることは確認しましたが、実際に試してはいません。
コメント