Pythonでウェブページの更新・価格変動を自動チェックする方法
気になるページの変化を、Pythonに見張ってもらいましょう
この記事は、「Pythonでできる日常の自動化6選」の番外編として、Webページの自動チェックの詳しい作り方をまとめた記事です(この1本だけ、少しレベルが上がります)。
気になる商品の値下げや、よく見るページの更新を、毎回自分でチェックしに行くのは意外と手間がかかります。1日1回でも、1年続ければ365回です。Pythonを使えば、ページの中身を定期的に取得し、前回チェックしたときと違いがあれば知らせてくれる仕組みを作ることができます。
この記事では、単に「変化した」と分かるだけでなく、複数のページをまとめて見張り、値段が何円下がったかまでメールで受け取るところまで作ります。最後に全部つなげた完成版のコードを載せているので、まずは動かしてから中身を読む、という進め方でも大丈夫です。
この記事は、Pythonでウェブページを扱うのが初めてではない方を想定しています。「プログラムでインターネットに触れるのが不安」「まず1回、動かして確かめたい」という方は、先に「Pythonでウェブページを取得してみる|こわくない最初の一歩」をお読みください。書くコードは8行だけ、15分で読み終わる内容です。そのうえでこの記事に戻ってくると、格段に進めやすくなります。
- 1
- 2
- 3
- 4
- 5
用意するもの
ページの取得と情報の抜き出しに、以下の2つのライブラリを使います。
- Python本体
requests(Webページを取得するライブラリ)beautifulsoup4(取得したページから必要な情報を抜き出すライブラリ)
Pythonのインストール、コードを書くためのエディタ(VS Code)の準備、コードの書き方・実行方法がまだの方は、先に「Pythonを始める前に:インストールとエディタの準備」を済ませてから、この続きに進んでください。
ターミナルで以下のコマンドを実行し、2つのライブラリをまとめてインストールします。
pip install requests beautifulsoup4インストールできたか不安なときは、次のコマンドで確認できます。バージョン番号が表示されれば成功です。
pip show requests beautifulsoup4インストールするときの名前はbeautifulsoup4ですが、コードの中で読み込むときの名前はbs4になります。ここは名前が一致していない珍しい例で、初めて使うときに戸惑いやすい部分です。
仕組みと、守るべきマナー
この記事で作るのは、「ページを取得する → 見たい部分の文字を抜き出す → 前回の値と比べる → 変わっていたら知らせる」という流れの仕組みです。この、Webページの情報をプログラムで自動的に取得する行為は「スクレイピング」と呼ばれます。便利な一方で、守るべきマナーがあります。ここを飛ばさずに読んでおいてください。
1. サイトの利用規約を確認する
サイトによっては、利用規約で自動取得を明確に禁止していることがあります。特に大手の通販サイトやSNSは禁止していることが多く、その場合は行ってはいけません。「サイト名 利用規約」で検索し、「自動」「プログラム」「収集」といった言葉を探すと見つかります。
2. robots.txtを見る
多くのサイトには、プログラムからのアクセスに関する方針を書いたrobots.txtというファイルが置かれています。サイトのトップページのURLの末尾に/robots.txtを付けてブラウザで開くと読めます。
https://example.com/robots.txtDisallow:の後ろに書かれているのが、アクセスを控えてほしいとサイト側が表明している場所です。見張りたいページがそこに含まれている場合は、やめておきましょう。
3. アクセスの間隔を空ける
短い間隔で何度もアクセスすると、サイト側のサーバーに負荷をかけてしまいます。値下げの検知が目的であれば、1時間に1回程度で十分です。1分ごとにチェックしても、得られるものはほとんど変わりません。複数のページを続けて取得する場合も、1件ごとに数秒待つようにします。
スクレイピングはあくまで個人が自分で見るための取得にとどめてください。取得した内容を自分のサイトに転載したり、データを再配布したりする行為は、著作権の問題につながります。また、ログインが必要なページの自動取得は規約違反になることがほとんどです。
ページの中身を取得してみる
まずは、指定したページを取得し、中の文字情報を抜き出す基本の流れを試してみましょう。
import requests
from bs4 import BeautifulSoup

url = "https://example.com/"
headers = {"User-Agent": "Mozilla/5.0 (check-script; personal use)"}

response = requests.get(url, headers=headers, timeout=20)
response.raise_for_status()  # 取得に失敗した場合はここでエラーになる

soup = BeautifulSoup(response.text, "html.parser")
title = soup.find("h1").get_text(strip=True)
print(title)実行すると、指定したページの<h1>タグの中の文字が表示されます。
headersで渡しているUser-Agentは、「どんなソフトからアクセスしているか」をサイトに伝える名札のようなものです。何も指定しないとPythonの標準の名札のままアクセスすることになり、サイトによっては弾かれます。timeout=20は、20秒たっても応答がなければ諦める、という指定です。これを付けておかないと、応答のないサイトに当たったときプログラムが止まったまま動かなくなります。
見たい情報の場所を調べる
価格など、ページ内の特定の情報を狙って抜き出したい場合は、その部分がどんなHTMLタグ・クラス名になっているかを調べます。手順は次の通りです。
- ブラウザ(Chrome)で対象のページを開く
- 抜き出したい部分(価格の文字など)の上で右クリックし、「検証」を選ぶ
- 画面の右側か下側にHTMLが表示され、選んだ部分が青くハイライトされる
- そのハイライトされた行にある
class="..."やid="..."の値を控える
たとえば<span class="price">1,280円</span>となっていれば、クラス名はpriceです。次のように書くと、その部分だけを抜き出せます。
# class="price" が付いた要素を取得する場合
price = soup.select_one(".price").get_text(strip=True)
print(price)

# id="price" の場合は . ではなく # を使う
price = soup.select_one("#price").get_text(strip=True)クラス名の前には.(ドット)、IDの前には#(シャープ)を付ける、と覚えてください。
サイトによってHTMLの構造は異なるため、この記事のコードをそのまま使っても動きません。「検証」で調べたクラス名やタグ名に、コード内の.priceの部分を必ず書き換えて使ってください。
そもそも取得できないページを見分ける
ここが、この仕組みを作るときに最初にぶつかる壁です。「検証」で調べたクラス名は合っているのに、Pythonで実行するとNoneになって取れない。この現象には、はっきりした原因があります。
最近のWebページには、最初に届くHTMLには価格が書かれておらず、ブラウザが後からJavaScriptで表示しているタイプのものが多くあります。ブラウザの「検証」で見えているのは表示され終わった後の状態なので、価格が見えます。しかしrequestsが受け取るのは表示される前のHTMLなので、そこには価格が存在しないのです。
見分け方
作り始める前に、1分でできる確認方法があります。ページ上で右クリックし、「ページのソースを表示」(「検証」ではありません)を選びます。表示された文字の中でCtrl+Fを押し、抜き出したい値そのもの(たとえば「1,280」)を検索してください。
- 見つかった →
requestsで取得できます。この記事の方法で作れます - 見つからない → JavaScriptで後から表示されています。この記事の方法では取得できません
取得できなかったときの選択肢
見つからなかった場合、無理に進めても時間を使うだけです。次のどれかに切り替えてください。
- 別のページを探す — 同じ情報が、スマートフォン向けページや一覧ページ側では素のHTMLに書かれていることがあります
- 公式の通知機能を使う — 多くの通販サイトには「お気に入り登録で値下げ通知」の機能があります。目的が達成できるなら、そちらが確実で、サイトにも負荷をかけません
- Selenium・Playwrightを使う — ブラウザそのものを自動操作するライブラリです。取得できるようになりますが、設定も動作も重くなります。初めての自動化としては、いったん見送ることをおすすめします
- RPAを使う — Windows 11に最初から入っている「Power Automate」は、実際にブラウザを開いて画面から値を拾います。そのため、JavaScriptで後から表示される値も取れました(実際に試して確認しています)。→ PythonとRPAで同じものを作って比べた記事
「取れないページもある」と先に知っておくと、うまくいかなかったときに「自分のコードが悪いのでは」と延々に悩まずに済みます。まずは取得できるページで仕組みを完成させてしまうのが近道です。
前回の内容と比較して変化を検知する
取得した値を毎回ファイルに保存しておき、次にチェックしたときの値と比較することで、変化があったかどうかを判定できます。
from pathlib import Path

save_file = Path("last_value.txt")
current_value = title  # 今回取得した値

if save_file.exists():
    previous_value = save_file.read_text(encoding="utf-8")
else:
    previous_value = None

if previous_value is None:
    print("初回の記録です")
elif previous_value != current_value:
    print("変化がありました!")
    print(f"前回: {previous_value}")
    print(f"今回: {current_value}")
else:
    print("変化はありませんでした")

# 今回の値を次回の比較用に保存しておく
save_file.write_text(current_value, encoding="utf-8")
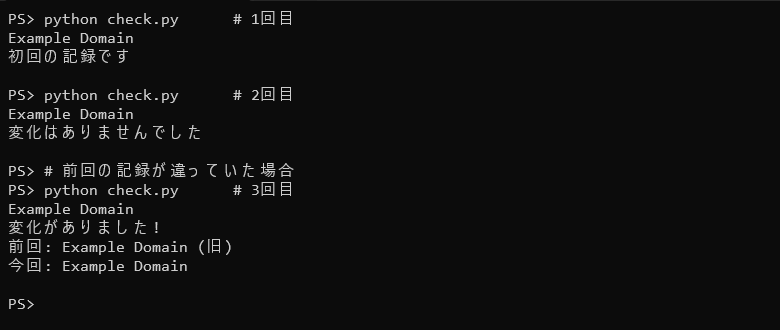
1回目の実行では比較する相手がいないため「初回の記録です」と表示され、値がファイルに保存されます。実際の変化を検知できるようになるのは2回目以降です。
実際に動かすと、こうなります
encoding="utf-8"は、日本語を正しく読み書きするための指定です。Windowsではこれを省略すると、保存と読み込みで文字の扱いが食い違い、日本語が化けたり実行時にエラーになったりします。ファイルを扱うときは付ける、と決めておくと安全です。
「いくら下がったか」まで分かるようにする
ここまでで「変わった/変わっていない」は分かりますが、値下げを見張るのであれば何円下がったのかが知りたいはずです。取得した文字から数字だけを取り出せば、引き算ができます。
価格は1,280円のように、カンマや「円」が混ざった文字として取得されます。そこで、数字以外を取り除いてから数値に変換します。
import re

def to_number(text):
    # 「1,280円」のような文字から数字だけを取り出して整数にする
    digits = re.sub(r"[^0-9]", "", text or "")
    return int(digits) if digits else None

before = to_number("1,280円")   # → 1280
after = to_number("1,180円")    # → 1180

diff = after - before
print(f"{diff:+,}円")           # → -100円
re.sub(r"[^0-9]", "", text)は、「数字ではない文字をすべて空文字に置き換える」という意味です。これで1,280円が1280になります。
また、f"{diff:+,}円"の+は、プラスのときも符号を付ける指定です。値上がりなら+100円、値下がりなら-100円と表示されるので、メールの件名を見ただけで方向が分かります。
ページによっては「1,280円」の近くに「送料500円」など別の数字が入っていることがあります。その場合、狙った場所より広い範囲を指定していると数字が混ざります。select_oneで指定する場所は、できるだけ価格だけを囲んでいる要素に絞ってください。
複数のページをまとめて見張る
見張りたいページは、たいてい1つではありません。チェックしたい対象をリストにまとめておけば、同じコードのまま何件でも増やせます。
TARGETS = [
    {"name": "商品A", "url": "https://example.com/item-a", "selector": ".price"},
    {"name": "商品B", "url": "https://example.com/item-b", "selector": "#price"},
    {"name": "お知らせページ", "url": "https://example.com/news", "selector": "h2"},
]

for target in TARGETS:
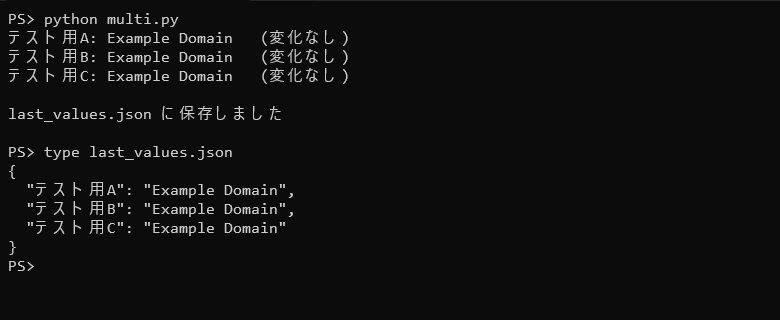
print(target["name"], target["url"])対象が増えると、保存する値も対象ごとに分ける必要があります。1つのテキストファイルでは足りないので、名前と値の組を丸ごと保存できるJSON形式に切り替えます。
複数にすると、こうなります
import json
from pathlib import Path

save_file = Path("last_values.json")

# 読み込み
if save_file.exists():
    previous = json.loads(save_file.read_text(encoding="utf-8"))
else:
    previous = {}

# 書き込み
current = {"商品A": "1,180円", "商品B": "3,000円"}
save_file.write_text(
    json.dumps(current, ensure_ascii=False, indent=2),
    encoding="utf-8",
)ensure_ascii=Falseを付けないと、日本語がファイルの中で記号の羅列になってしまいます。後から自分でファイルを開いて確認したいので、付けておきましょう。indent=2は改行して読みやすく保存するための指定です。
対象ごとにページの構造が違うため、selectorも対象ごとに変わります。リストの中に一緒に書いておくと、後から見張る対象を足すときも、この部分に1行足すだけで済みます。
変化があったら通知する
変化を検知したときに、自分宛にメールを送るようにすれば、わざわざチェック結果を見に行かなくても済みます。メールの送信には、Gmailの「アプリパスワード」という仕組みを使います。ここでは、変化検知の部分と組み合わせた例を紹介します。
import smtplib
from email.message import EmailMessage

GMAIL_ADDRESS = "your_address@gmail.com"
APP_PASSWORD = "発行した16桁のアプリパスワード"

def notify(body):
    msg = EmailMessage()
    msg["Subject"] = "チェックしているページに変化がありました"
    msg["From"] = GMAIL_ADDRESS
    msg["To"] = GMAIL_ADDRESS
    msg.set_content(body)

    with smtplib.SMTP_SSL("smtp.gmail.com", 465) as server:
        server.login(GMAIL_ADDRESS, APP_PASSWORD)
        server.send_message(msg)
print("通知メールを送信しました")変化があったものだけをリストに集めておき、1件でもあれば最後にまとめて1通送るのがコツです。対象ごとに1通ずつ送ると、10件見張っていれば10通届くことになり、かえって見落とします。
Gmailのアプリパスワードは、あなたのアカウントにアクセスできる鍵そのものです。コードをそのままブログやSNSに貼ったり、他人と共有するフォルダに置いたりしないよう注意してください。
1時間ごとに自動実行する
ここまでのコードは、自分で実行したときにだけチェックが行われます。「1時間ごとに勝手にチェックしてほしい」という状態にするには、Windowsに最初から入っているタスクスケジューラを使います。
1. 起動用のファイルを作る
まず、Pythonスクリプトを呼び出すだけの小さなファイルを作ります。メモ帳に次の2行を書き、check.batという名前で、スクリプトと同じフォルダに保存してください(保存時に「ファイルの種類」を「すべてのファイル」にするのを忘れずに)。
cd /d C:\Users\あなたの名前\Documents\web-check
python check.py1行目でスクリプトのある場所に移動し、2行目で実行しています。cdで移動しておかないと、保存ファイル(last_values.json)が思わぬ場所に作られてしまいます。
2. タスクスケジューラに登録する
- スタートメニューで「タスクスケジューラ」と検索して開く
- 右側の「基本タスクの作成」をクリック
- 名前に「Webページチェック」などと入力して「次へ」
- トリガーで「毎日」を選び、開始時刻を指定して「次へ」
- 操作で「プログラムの開始」を選び、先ほどの
check.batを指定して「完了」
1時間ごとにしたい場合は、作成後にそのタスクを右クリック→「プロパティ」→「トリガー」タブ→「編集」で、「繰り返し間隔」を1時間、「継続時間」を1日に設定します。基本タスクの作成画面には1時間ごとの選択肢がないため、作った後から変更する必要があります。
登録したら、そのタスクを右クリックして「実行」を選び、手動で1回動かして確認してください。黒い画面が一瞬光って終われば成功です。何も起きない場合は、check.batをダブルクリックして直接動くかを先に確かめると、原因がタスク側かコード側か切り分けられます。
パソコンの電源が切れている間や、スリープ中は実行されません。「1時間ごと」にしても、確実に1日24回動くわけではない点は理解しておいてください。値下げの見張りのような用途では、多少抜けても実用上は問題ありません。
完成版:全部つなげたコード
ここまでの内容をすべて1つにまとめたものです。TARGETSとGmailの2行を自分の内容に書き換えれば、そのまま動きます。
import json
import re
import smtplib
import time
from email.message import EmailMessage
from pathlib import Path

import requests
from bs4 import BeautifulSoup

# ==== ここを自分の内容に書き換える ====
TARGETS = [
    {"name": "商品A", "url": "https://example.com/item-a", "selector": ".price"},
    {"name": "商品B", "url": "https://example.com/item-b", "selector": "#price"},
]
GMAIL_ADDRESS = "your_address@gmail.com"
APP_PASSWORD = "発行した16桁のアプリパスワード"
# ====================================

SAVE_FILE = Path("last_values.json")
HEADERS = {"User-Agent": "Mozilla/5.0 (check-script; personal use)"}
WAIT_SECONDS = 5  # 1件ごとに待つ秒数


def fetch_value(target):
    # 1件分のページを取得し、指定した場所の文字を返す
    response = requests.get(target["url"], headers=HEADERS, timeout=20)
    response.raise_for_status()
    soup = BeautifulSoup(response.text, "html.parser")
    element = soup.select_one(target["selector"])
    if element is None:
        return None
    return element.get_text(strip=True)


def to_number(text):
    # 「1,280円」のような文字から数字だけを取り出して整数にする
    digits = re.sub(r"[^0-9]", "", text or "")
    return int(digits) if digits else None


def notify(body):
    msg = EmailMessage()
    msg["Subject"] = "チェックしているページに変化がありました"
    msg["From"] = GMAIL_ADDRESS
    msg["To"] = GMAIL_ADDRESS
    msg.set_content(body)
    with smtplib.SMTP_SSL("smtp.gmail.com", 465) as server:
        server.login(GMAIL_ADDRESS, APP_PASSWORD)
        server.send_message(msg)
    print("通知メールを送信しました")

def main():
    if SAVE_FILE.exists():
        previous = json.loads(SAVE_FILE.read_text(encoding="utf-8"))
    else:
        previous = {}

    current = {}
    changes = []

    for target in TARGETS:
        name = target["name"]
        try:
            value = fetch_value(target)
        except Exception as error:
            print(f"{name}: 取得に失敗しました({error})")
            continue

        if value is None:
            print(f"{name}: 指定した場所が見つかりませんでした")
            continue

        current[name] = value
        before = previous.get(name)

        if before is None:
            print(f"{name}: 初回の記録({value})")
        elif before != value:
            line = f"{name}: {before} → {value}"
            before_num = to_number(before)
            value_num = to_number(value)
            if before_num is not None and value_num is not None:
                line += f" ({value_num - before_num:+,}円)"
            print("変化あり " + line)
            changes.append(line)
        else:
            print(f"{name}: 変化なし({value})")

        time.sleep(WAIT_SECONDS)

    # 取得できなかった対象は、前回の値をそのまま引き継ぐ
    merged = {**previous, **current}
    SAVE_FILE.write_text(
        json.dumps(merged, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )

    if changes:
        notify("\n".join(changes))
    else:
        print("変化はありませんでした")


if __name__ == "__main__":
main()1件でも取得に失敗したときにプログラム全体が止まらないよう、tryで囲んでcontinueしています。見張る対象が10件あって1件だけ構造が変わった、というときでも、残りの9件のチェックは続きます。長く動かし続ける仕組みでは、この「1件の失敗で全部を止めない」作りが効いてきます。
うまくいかないときのトラブルシューティング
ModuleNotFoundError: No module named 'bs4'と出ます▼pip install beautifulsoup4を実行してください(bs4ではなくbeautifulsoup4です)。それでも直らない場合は、複数のPythonが混在している可能性があります。python -m pip install beautifulsoup4のようにpython -mを付けて実行すると、いま使っているPythonに確実に入ります。soup.select_one(...)がNoneになってエラーが出ます▼class="price sale"のように複数ある場合は、.priceだけでも指定できます。requestsだけでは取得できません。「ページのソースを表示」で値を検索して確認してください。この記事の「そもそも取得できないページを見分ける」で、見分け方と代わりの手段を説明しています。403 Client Errorと表示されて取得できません▼User-Agentを指定していない場合は、記事のコードのように付けてみてください。それでも拒否される場合は、サイト側が自動取得を明確に拒んでいるということなので、その対象は諦めてください。回避しようとする行為は規約違反にあたります。printで取得した値を毎回表示させ、どこが変わっているかを確認してください。select_oneで指定する範囲を、見張りたい値だけに絞るのが解決策です。selectorの部分を修正してください。壊れること前提で、直しやすい形(設定を上部にまとめる)にしておくのがコツです。まとめ
requestsとbeautifulsoup4を使って、Webページの内容を取得し、前回との変化を検知して通知するところまで作りました。最後に要点を整理します。
- 作る前に確認する — 利用規約と
robots.txtを見て、やってよい対象かを判断する - 取れるページか先に見分ける — 「ページのソースを表示」で値を検索。見つからなければJavaScript製で、この方法では取得できない
- 比較は保存から — 前回の値をファイルに残しておくことで、初めて「変化」が分かる
- 数字に変換すると実用的になる — 「変わった」ではなく「100円下がった」と分かる
- 頻度は控えめに — 1時間に1回で十分。相手のサーバーに負荷をかけない
- いつか壊れる前提で作る — 相手のサイトの構造が変われば動かなくなる。設定を上にまとめて直しやすくしておく
まずは自分がよく見るページを1つだけ登録して、動かしてみてください。仕組みが動き出すと、「毎日見に行く」という小さな手間が1つ減ります。
同じ仕組みを、RPAで作るとどうなるか
この記事とまったく同じ「ページの更新を見張る」仕組みを、Windows 11に最初から入っているRPAでも作ってみました。出てきた結果は1文字も同じ。でも壊れる条件は正反対で、留守中に動かせるのは片方だけでした。
PythonとRPAを比べた記事を読む
コメント